
朝、いつものようにDiscordからHermes Agentへ声をかけた。しかし、返事がない。画面の向こうで考え込んでいるのか、それとも通信が切れたのか。実はHermesは、こちらを無視していたのではなかった。自分の「記憶」を壊さないため、あえて口を閉ざしていたのである。
その日の調査は、単なる再起動では終わらなかった。会話履歴を持つSQLite、書き込み途中を支えるWAL、複数の常駐処理、そして止まっていた定期実行。今回は、沈黙の正体を見つけ、記憶を守ったまま復旧し、滞留した仕事まで取り戻した一日を、再現可能な手順とともに物語として残す。
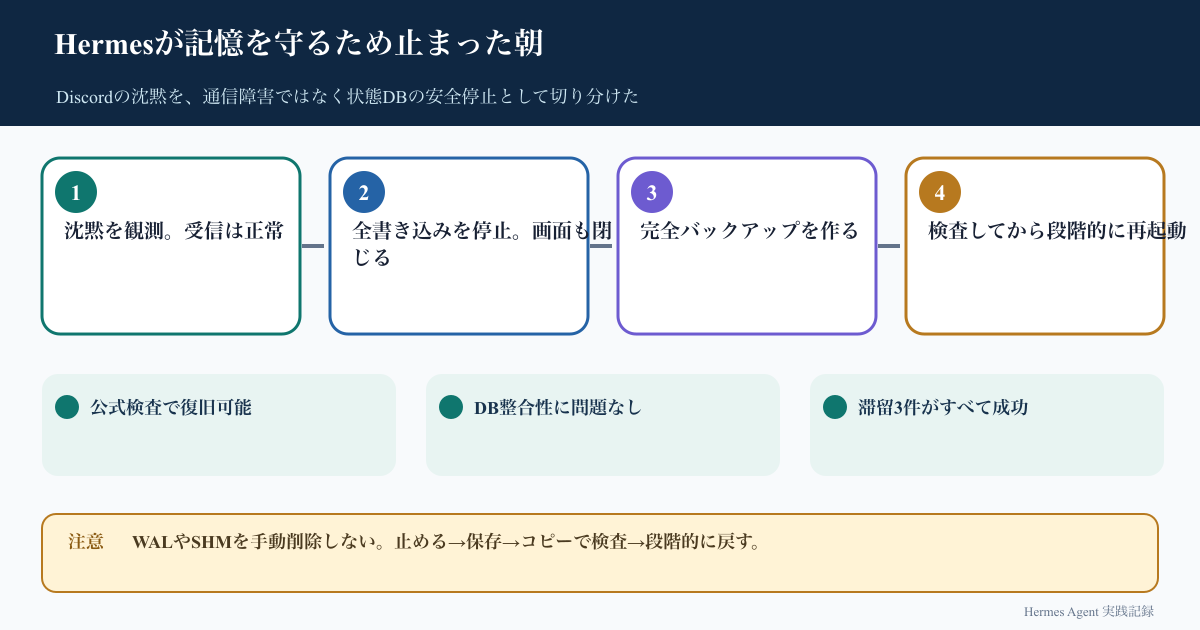
最近の取り組みで確認できたこと
最初の違和感はDiscordの沈黙だった。ところが調べると、受信経路そのものは動いていた。メッセージは届いている。それでも通常の返答を作れない。さらに同じ時間帯に、エージェントを使う定期実行が3件失敗していた。一方、エージェントを介さない単純な処理は完了している。犯人は「Discord」ではなく、その奥にいるHermes本体らしい。
ログに現れた手がかりは、削除済みのWAL世代を検知したという安全停止だった。常駐中の複数プロセスが古いWALを握ったまま、ファイルパス側では新しい世代が見えていた。Hermesは、この状態で書き込みを続けると別々の履歴が生まれる危険があると判断し、処理を拒んでいた。
重要なのは、主データベースが壊れていたと即断しないことだ。実際、退避コピーに対する公式の検査は `recoverable: true`、SQLiteの `quick_check` は `ok`。2万6千件を超えるメッセージと800件を超えるセッションも読み取れた。沈黙は故障そのものではなく、記憶を守る門番が働いた結果だった。
仕組みを分解する
Hermes Agentの会話は、SQLiteの状態データベースに保存される。SQLiteをWALモードで使うと、変更はまず `-wal` ファイルへ追記され、読み書きの調整には `-shm` が関わる。つまり安全な退避単位はデータベース本体だけではない。本体、WAL、SHMを同じ時点の一組として扱う必要がある。
物語の登場人物に置き換えると分かりやすい。データベース本体は「本棚」、WALはまだ本棚へ整理されていない「新着ノート」、SHMは誰がどこを読んでいるかを示す「閲覧札」だ。店員が古い新着ノートを抱えたまま、棚の前に別の新着ノートが置かれたら、どちらを正史として扱うか分からない。そこでHermesは新しい書き込みを止めた。
今回の有力な背景は、更新と再起動の境界で複数の常駐処理がそろって切り替わらなかったことだった。ただし、更新そのものを単独の原因と断定はしない。確認できた事実は「古いWALを保持するプロセス」と「新しいパス上のWAL」が同時に存在したことだ。原因と観測事実を分けると、復旧作業で思い込みによる破壊を避けられる。
小さく再現する手順
まず、書き込み主体をすべて止める。Gatewayだけでなく、デスクトップ画面、定期実行、バックグラウンドで状態DBを開く可能性のある処理も対象だ。ひとつでも古い接続が残れば、再起動した処理と世代が食い違う可能性がある。
次に、元ファイルへ修復操作をかけず、データベース本体・WAL・SHM・関連する退避物を日時付きフォルダーへコピーする。今回は約1.4GBの復旧束を作り、元とコピーのSHA-256が一致することを確認した。検査対象は必ずコピーにする。
その後、導入済みHermesの公式検査を読み取り専用で実行する。
“`bash
hermes sessions recover \
–source /path/to/backup/state.db \
–inspect-only
“`
併せてSQLiteの整合性検査をコピー上で行う。両方が正常なら、最新版へ更新し、サービス定義をそろえてからGatewayと画面を順に起動する。最後は単なる「プロセス起動中」ではなく、ローカル応答、Discordからの実受信、Discordへの実返信という三段階で確認する。
確認指標
復旧判定は、緑色のランプ一個に任せない。今回は次の観測をそろえた。
- 公式検査が `recoverable: true` で、エラーが0件
- SQLiteの `quick_check` が `ok`
- セッションとメッセージの主要テーブルを読み取れる
- ローカルの短い応答テストが指定どおり返る
- Discordの新規メッセージへ通常の返答が届く
- 起動時に保留中の1件が自動回収される
- 失敗していた3件を順番に再実行し、すべて成功する
- 新しい退避WAL世代や保留メッセージが増えていない
ここまでそろって、ようやく「復旧した」と言える。起動確認は入口であり、利用者の経路と滞留処理まで通すのが出口である。
失敗しやすい点と安全策
最も危険なのは、容量が大きい、名前が怪しいという理由だけで `-wal` や `-shm` を手で削除することだ。SQLite公式資料でも、WALはデータベースの永続状態の一部であり、本体と離すと確定済み取引を失う可能性があると説明されている。焦って掃除すると、助けるはずの作業が記憶の切断になる。
二つ目は、Gatewayだけを止めて安心すること。画面や別の常駐処理が接続を保持していれば、古い世代は生き続ける。開いているプロセスを洗い出し、すべての書き込み主体を閉じてから退避する。
三つ目は、失敗した定期実行をまとめて並列再実行することだ。状態DBへ同時に負荷を戻すと、原因の切り分けが難しくなる。今回は3件だけを対象にし、1件ずつ完了を確認した。もともと成功していた処理は再実行せず、重複投稿や二重通知も避けた。
再現チェックリスト
- [ ] Discordの受信、応答生成、返信を別々に確認した
- [ ] 状態DBを開いている全プロセスを停止した
- [ ] DB・WAL・SHMを同じ退避先へ保存した
- [ ] ハッシュで元と退避コピーの一致を確認した
- [ ] 修復前の検査は退避コピーで実行した
- [ ] エラー表示と、実際の整合性検査結果を分けて記録した
- [ ] 更新後にサービス定義をそろえて再起動した
- [ ] ローカル応答とDiscord実通信を両方試した
- [ ] 失敗した処理だけを一件ずつ再実行した
- [ ] 保留メッセージと新たなWAL異常がないことを再確認した
次に改善するなら
次の一手は、「Discordが無言」という利用者目線の症状を、内部指標へ結びつける監視だ。受信時刻、応答作成の成否、送信結果、状態DBの安全停止、定期実行の失敗数を一枚の健康診断にまとめる。受信はできるが返答できない状態を、単なる接続断と区別できるようにする。
また、更新前チェックとして、状態DBを開いているプロセス一覧、未処理メッセージ数、実行中ジョブ数を保存する。更新後には同じ項目を比較し、世代の不一致を早期に検出する。定期バックアップはDB単体ではなく、WALとSHMを含む一貫した方法に統一したい。
夕方、Hermesは再びDiscordで答えた。止まっていた3件の仕事も、順番に終えた。今回いちばん頼もしかったのは、何でも強引に続けることではない。危険を見つけたときに黙り、記憶を守ったことだった。自動化の信頼性は「止まらないこと」だけではない。「安全に止まり、正しく戻れること」でも育つ。
参考情報
- [Hermes Agent: Messaging](https://github.com/NousResearch/hermes-agent/blob/main/website/docs/user-guide/messaging/index.md)
- [Hermes Agent: Sessions](https://github.com/NousResearch/hermes-agent/blob/main/website/docs/user-guide/sessions.md)
- [Hermes Agent: CLI Commands](https://github.com/NousResearch/hermes-agent/blob/main/website/docs/reference/cli-commands.md)
- [SQLite: Write-Ahead Logging](https://sqlite.org/wal.html)
- [SQLite: How To Corrupt An SQLite Database File](https://sqlite.org/howtocorrupt.html)
※本記事は2026年9月14日時点の公式資料と実運用記録を基にしています。公開本文では個人名、アカウント、内部パス、チャンネル識別子、認証情報を伏せています。