
予定件数・起動件数・完走件数を分ける—日次AIバッチの数字の読み方
AIエージェントの定期処理では、処理を作ること以上に「本当に狙った成果が残ったか」を確認する設計が重要です。今回の題材は、最近のHermes Agent周辺の運用記録から切り出しました。中心となる課題は、**100件体制という計画値と、実際に起動・完走・保存した件数を混ぜると障害を見逃す**ことです。
本記事は、特定環境の秘密値や内部識別子を載せず、読者が小さな検証環境で考え方を再現できる形に一般化しています。観測できた事実と、これから実装したい改善を混ぜません。株式・評価データに触れる場合も、目的はソフトウェアとデータ運用の説明であり、特定の売買を勧めるものではありません。
最近の取り組みで確認できたこと
1つ目は、**日ごとに記録されたセッション数と評価件数に差があった**ことです。これは2026-08-20の日次記録で確認しました。記録にない成功を補わず、実行済み・確認済みの範囲と、今後の改善候補を分けて扱います。
2つ目は、**認証エラー終了の疑いを別項目として残した**ことです。これは2026-08-21の日次記録で確認しました。記録にない成功を補わず、実行済み・確認済みの範囲と、今後の改善候補を分けて扱います。
3つ目は、**正常日もプローブ等を除外して完走件数を整理した**ことです。これは2026-08-25の日次記録で確認しました。記録にない成功を補わず、実行済み・確認済みの範囲と、今後の改善候補を分けて扱います。
一連の記録から分かるのは、AIの回答本文だけを成果物とみなすと、運用状態を正しく把握できないという点です。起動したこと、モデルや外部サービスへ到達したこと、対象ごとの結果が保存されたこと、集計が完了したことは別のイベントです。記事では、この境界を再現可能な確認手順へ落とし込みます。
仕組みを分解する
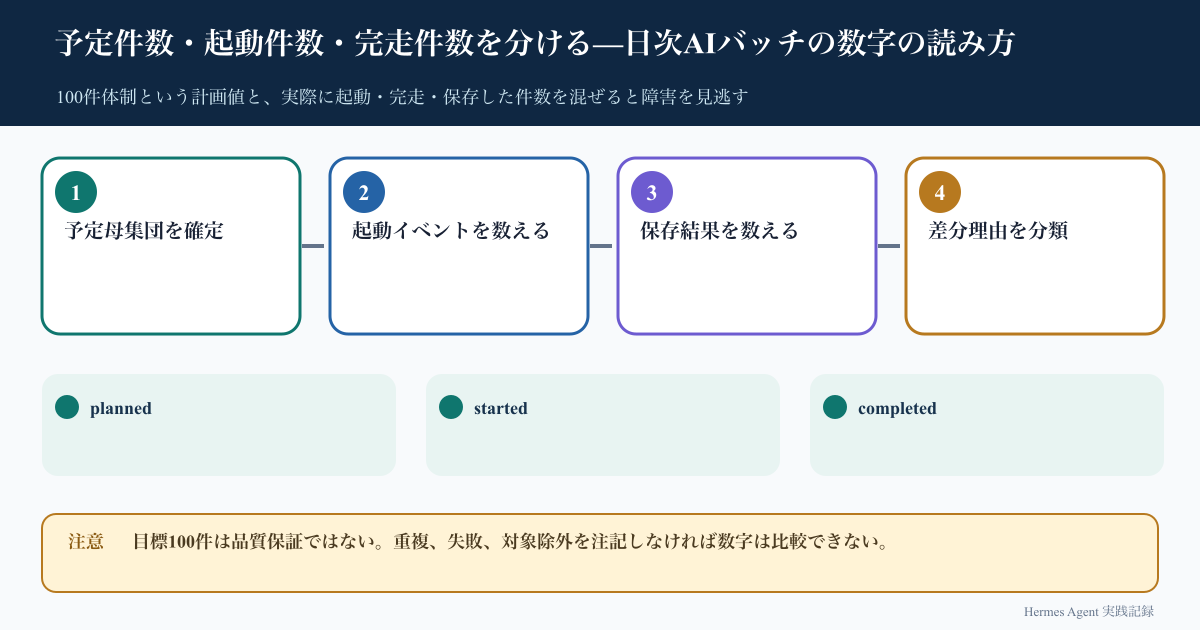
全体は次の四段階に分けます。
1. **予定母集団を確定**
2. **起動イベントを数える**
3. **保存結果を数える**
4. **差分理由を分類**
第一段階では入力の基準日、対象集合、処理種別を固定します。実行中に母集団が変わると、成功率や欠損数を比較できません。入力一覧には生成時刻とハッシュを添え、後から同じ対象を再現できるようにします。
第二段階では、外部CLIやAPIへの疎通と、本来の高コスト処理を分けます。短い確認が失敗した場合は本処理へ進まず、認証、ネットワーク、入力不備のどこで止まったかを記録します。ここで無制限リトライはせず、同じ原因が続く場合は人へ通知します。
第三段階では、対象単位の結果へ一意なキーを付けます。推奨するキーは「基準日・処理種別・対象ID」の組です。同じキーの再実行は上書き、履歴追加、拒否のどれにするかを事前に決めます。これにより、途中失敗からの部分再実行がしやすくなります。
第四段階では、ジョブの終了表示ではなく成果物を集計します。期待対象、起動済み、保存済み、検証済みを別々に数え、差分へ理由を付けます。目標100件は品質保証ではない。重複、失敗、対象除外を注記しなければ数字は比較できない。
小さく再現する手順
最初から本番データを使わず、架空の対象3件で確認します。保存先や認証値は `/path/to/project` と `YOUR_*` へ置き換えてください。
“`text
run_date = "2026-09-14"
expected = ["DEMO-A", "DEMO-B", "DEMO-C"]
1. expectedを読み取り専用スナップショットとして保存する
2. 軽量な疎通確認を1回だけ実行する
3. 対象ごとの結果を run_date + process + target で保存する
4. saved IDs と expected IDs の差集合を計算する
5. 差集合が空の場合だけ verified と記録する
“`
実装言語は問いません。大切なのは、成功判定を一つの真偽値へ潰さないことです。JSONなら `probe_ok`、`started_at`、`finished_at`、`target_id`、`artifact_path`、`verified_at`、`error_type` を分けます。SQLiteなら同じ項目を列にし、実行履歴と成果物テーブルを分離します。
手動確認では、まず小さなfixtureで正常系を通し、次に認証失敗、対象一件の失敗、保存後の検証失敗を意図的に作ります。エラー時に「0件」とだけ表示されず、原因が分かる状態になれば第一段階は合格です。実データへ広げるのは、その後です。
確認指標
- **完走率**:日次または処理単位で値と確認時刻を残し、前回値との差を説明できるようにします。
- **欠損率**:日次または処理単位で値と確認時刻を残し、前回値との差を説明できるようにします。
- **重複・除外率**:日次または処理単位で値と確認時刻を残し、前回値との差を説明できるようにします。
指標は多ければ良いわけではありません。毎日見るものは三つ程度に絞り、詳細ログへ辿れるリンクまたは実行IDを残します。観測値には母集団、基準日、集計時刻を添えます。暫定値は「暫定」、未確認は「未確認」と明記し、0と不明を分けます。
異常判定の閾値は、過去の分布と業務影響から決めます。この記事に出てくる件数をそのまま別環境の閾値にしないでください。少数環境では一件の欠損でも重大ですが、大規模環境では率と連続回数を併用した方がよい場合があります。
失敗しやすい点と安全策
1. ジョブ数と対象数を同義にする
対策は、処理の入口・成果物・終了状態を別々に記録し、どこまで確認できたかを短い文章で添えることです。自動化の成功表示だけで結論を出さず、再実行前には重複と影響範囲を確認します。
2. 正常終了数だけで保存成功を判断する
対策は、処理の入口・成果物・終了状態を別々に記録し、どこまで確認できたかを短い文章で添えることです。自動化の成功表示だけで結論を出さず、再実行前には重複と影響範囲を確認します。
3. 日ごとに母集団が違うのに単純比較する
対策は、処理の入口・成果物・終了状態を別々に記録し、どこまで確認できたかを短い文章で添えることです。自動化の成功表示だけで結論を出さず、再実行前には重複と影響範囲を確認します。
共通の安全策は、再実行を始める前に現在の状態を保存することです。設定、対象一覧、成果物の件数、最後に成功した時刻を記録し、変更後に同じ観点で比較します。秘密情報や実データはブログや通知へ転記せず、公開例は架空値に置き換えます。
再現チェックリスト
- [ ] 入力の基準日と対象集合を固定した
- [ ] 起動、疎通、保存、検証を別の状態として記録した
- [ ] 対象単位の一意なキーと再実行時の動作を決めた
- [ ] 正常な0件と取得・認証エラーを区別した
- [ ] 欠損と重複をID単位で確認した
- [ ] 秘密情報と個人情報を公開用の例から除いた
- [ ] 残課題を実装済みの成果として書いていない
次に改善するなら
次の改善候補は、**日次サマリーへplanned/started/completed/verifiedの四列を固定表示する**ことです。これは記事作成時点の次段階であり、完了済みとは扱いません。導入する場合は、まず小さな検証データと失敗fixtureで動作を確認し、その後に日次バッチへ接続します。
また、通知の文面は「成功」「警告」「失敗」を分け、成功時にも確認した成果物件数を含めます。運用者が通知一通から、再実行が必要か、待てばよいか、認証操作が必要かを判断できる粒度が目安です。
参考情報
- 本記事の根拠にした日次記録日: 2026-08-20, 2026-08-21, 2026-08-25, 2026-09-11
- 情報・実装確認日: 2026-09-14
- [Hermes Agent documentation](https://hermes-agent.nousresearch.com/docs/)
公式ドキュメントは機能やCLIの入口を確認するために参照し、手元の実行結果は日次記録と成果物で確認しました。仕様、モデル、価格、提供条件は変わる可能性があるため、再現時には公式情報をもう一度確認してください。