
記事収集の品質は、検索結果を多く集めるだけでは上がりません。同じ記事への共有リンクが別々に届くと重複が増え、今日紹介された古い論文を新着と扱えば、情報の鮮度も誤ります。要約を始める前に、リンクと日付の意味をそろえる必要があります。
2026年9月27日に実装されたX記事収集処理では、arXivの公開日抽出とYouTube共有パラメーターの扱いを修正しました。本記事は、そのコードとテストから読み取れる設計を解説します。定刻配信の稼働報告ではなく、収集した情報を壊さずに整理するための情報記事です。
最近の取り組みで確認できたこと
日次記録には、収集処理の実装とバグ修正のコミット、全体の61テスト通過が残っています。今回の執筆では実ファイルと変更履歴を照合し、9月28日に記事処理部分のテストを再実行しました。結果は22件成功です。61件は前日の記録値、22件は今回の再確認値であり、同じ検証範囲ではありません。
修正の一つは、arXivのHTML版やPDF版のリンクを受け取った際、メタデータ取得用に要旨ページを選ぶことです。もう一つは、YouTube系ホストに限って共有用パラメーターを除くことです。他サイトの同名パラメーターは残すテストも追加されています。
ここまでで確認したのは、変換規則と固定入力に対する動作です。今回、有料検索、実投稿の収集、通知送信は行っていません。朝のタスク登録や継続運転の完了も、このテスト結果からは判断できません。
仕組みを分解する
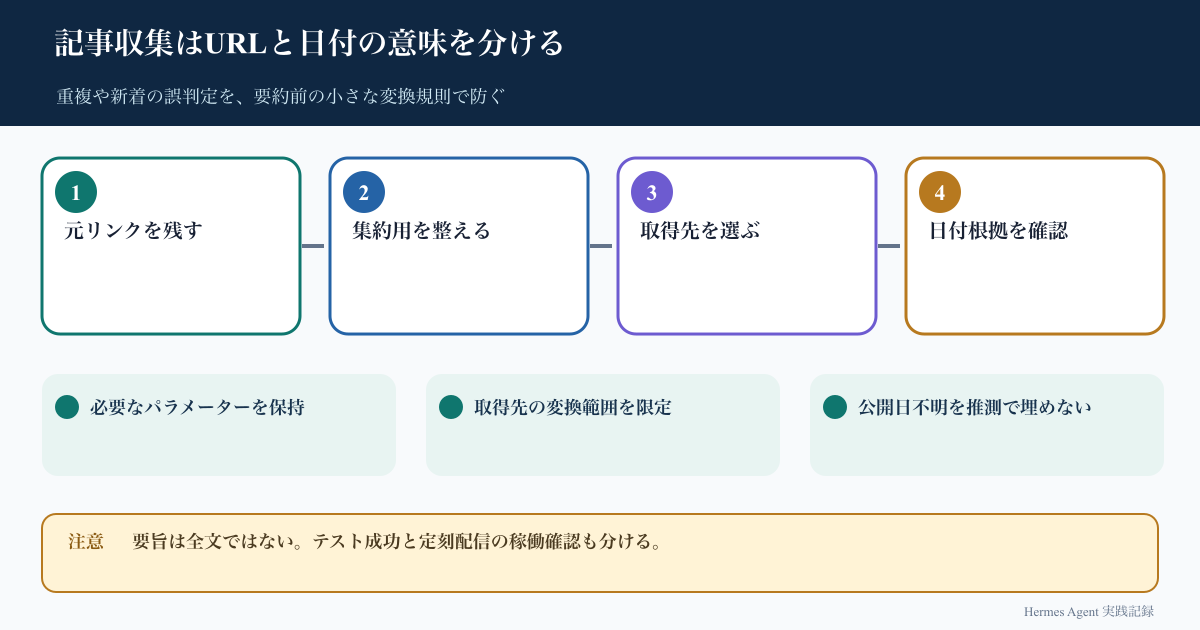
1. 元リンクを証拠として残す
収集時のリンクは、利用者が何を紹介したかをたどるための情報です。これを正規化後の値だけに置き換えると、どの変更が重複除去に効いたのかを調べにくくなります。実装では元リンクと集約用URLを別の項目に保持しています。公開ログへ出す際は、元リンクにも秘密値がないか確認します。
2. 集約用URLは限定的に整える
集約用には、既知の追跡パラメーターなどを除いたURLを使います。ただし「クエリを全部消す」のは危険です。記事番号、動画識別子、ページ番号まで失えば、別の内容が同一扱いになります。今回の修正は、ホストごとの除去集合を追加し、YouTube以外の`si`を維持するものでした。
これは提供元の永久的な仕様保証ではなく、この収集器のローカルな変換方針です。`si`、`feature`、`pp`の除去は対象ホストに限定されます。すべての共有形式や動画の再生位置が同一の内容を指すと保証したわけではありません。
3. 取得用URLを別に選ぶ
arXivでは、読むためのHTML・PDFと、書誌情報を確認する要旨ページを分けて扱います。実装は対応する数値形式の識別子を認識し、取得時だけ`abs`形式へ変換します。版番号がある場合は保持します。一般サイトの似たパスや、対応外のパスは変換しません。
重要なのは、取得先を変えても集約キーまで自動的に同じにしないことです。今回の修正だけで、同じ論文のPDF版とHTML版が必ず一件へ統合されるわけではありません。また、要旨ページから抜き出した文章は論文全文ではありません。下流の要約でも「論文全体を読んだ」と表現しない境界が必要です。
4. 日付は意味と根拠で選ぶ
投稿日時は「紹介された時」、記事公開日は「資料が公開された時」です。実装では別フィールドにしています。公開日メタにも優先順位を設け、一般的な`date`より`article:published_time`などを先に使い、引用向けの`citation_date`も候補に加えました。スラッシュ区切りの日付はハイフン区切りへそろえます。
ただし、書式をそろえることと日付の意味を保証することは別です。公式arXiv API資料も、初回提出を示す`published`と最終更新を示す`updated`を区別しています。今回のHTMLメタ抽出はAPIの両項目を取得する実装ではないため、初版日と改訂日を完全に区別できたとは書けません。
小さく再現する手順
まずネットワークへ接続せず、変換前後の期待値を固定します。以下は架空の値を使った比較例で、アクセス先の存在確認を目的にしていません。
“`text
入力: https://example.com/read?id=7&si=demo
期待: id と si を両方保持する
入力: https://www.youtube.com/watch?v=YOUR_VIDEO_ID&si=demo
期待: v を保持し、このホストでは si を除く
HTML: <meta name="citation_date" content="2026/09/01">
期待: 公開日候補を 2026-09-01 として取り出す
“`
次に、公開日メタと汎用の日付メタを同じHTMLへ入れ、記載順を逆にしても公開日側が優先されるか確認します。日付メタが一つもない場合は「不明」のままにします。投稿時刻や実行日で補完して、見かけの取得率を上げてはいけません。
取得先変換のテストでは、arXivの対応パス、版番号付き、一般サイトの似たパスを並べます。本文取得まで試す場合も、最初はモック応答で十分です。今回再実行したテストには、内部向けリダイレクトの拒否、HTML以外の応答、取得サイズの上限確認も含まれています。
確認指標
第一は、**残すべき情報の保持**です。動画識別子や他サイトのパラメーターが失われていないかを期待値と比較します。重複件数が減ったという数字だけでは、誤って異なる記事を統合した可能性を除外できません。
第二は、**取得先変更の範囲**です。対応ホスト・対応パスだけが変換され、元リンクと版番号が保たれることを確認します。第三は、**日付の根拠**です。不明が不明のまま残り、汎用メタが優先度の高い公開日メタを上書きしないことを合格条件にします。
これらはテストで確認する条件です。実運用の重複削減率や公開日正解率は今回測定していません。運用へ広げる際は、人が確認した少量の正解データと照合し、変換前後の件数だけでなく誤統合も記録するのが次の段階です。
失敗しやすい点と安全策
- **同じ名前のパラメーターを全サイトから消す。** 除去規則をホストごとに限定し、残す側のテストも用意します。
- **要旨取得を全文確認と呼ぶ。** 取得した表現の種類を明記し、要旨にない結論を補いません。
- **公開日不明を投稿日時で埋める。** 別項目で保持し、古い資料の再紹介も区別できるようにします。
- **URLを分解できたので安全と考える。** Python公式資料は`urlsplit()`が入力の妥当性検証を行わないと明記しています。接続許可の判定は別に必要です。
- **テスト成功を本番の安全保証にする。** 固定ケースの成功は、すべてのDNS変化や不正URLへの耐性を証明しません。実装には接続前とリダイレクト先の検査がありますが、接続時の名前解決との競合などは別の評価課題です。
再現チェックリスト
- [ ] 元リンクと集約用URLを分けた
- [ ] 取得用URLを集約キーと混同していない
- [ ] ホスト限定の除去規則を用意した
- [ ] 除かずに残す入力もテストした
- [ ] 投稿日時と記事公開日を別項目にした
- [ ] 日付がないケースを不明として保持した
- [ ] 要旨と全文の確認範囲を区別した
- [ ] 単体テストと定刻配信の確認を分けた
次に改善するなら
日付の値に加えて、採用したメタ名と取得した表現を保存すると監査しやすくなります。初版日と改訂日の分離、旧形式の論文識別子への対応、HTML版とPDF版を同一論文として扱う条件も追加候補です。いずれも今回の修正で完了した機能ではありません。まず情報を失わない小さな規則を固定し、その後に統合範囲を広げる順序が安全です。
参考情報
- 執筆根拠:2026年9月27日の非公開日次記録、記事処理コード、変更履歴、回帰テスト。9月28日に関連22テストを再実行。私的な原資料は公開していません。
- [Python公式:urllib.parse](https://docs.python.org/3/library/urllib.parse.html) — URLの分解・再構築と入力検証の注意。2026年9月28日確認。
- [arXiv公式:API User's Manual](https://info.arxiv.org/help/api/user-manual.html) — 公開・更新日時と版指定の区別。2026年9月28日確認。HTMLメタ抽出の動作保証としてではなく、日付の意味を区別する根拠として参照。