
データ分析の対象を広げるとき、画面に区分を追加するだけで済むとは限りません。新しい銘柄の価格を保存した結果、以前から使っていた平均や中央値まで変わることがあります。処理は正常終了しているのに、指標の意味だけが静かに変わる。対象拡張で警戒したいのは、このような見えにくい影響です。
今回は、テーマ別の観測をプライム・スタンダード・グロースの市場別へ広げた取り組みを扱います。主題は売買判断ではなく、比較軸とデータの境界をどう守るかです。本記事はソフトウェア・データ運用の説明であり、投資助言ではありません。市場ヒートの順位やスコアは利益を保証しません。
最近の取り組みで確認できたこと
2026年9月14日の設計記録では、既存データベースにグロース市場の銘柄・価格が未登録であることを確認し、市場別のヒート指標を追加する計画を整理しました。この時点では承認待ちで、実装済みとは扱えません。
翌15日の記録には、市場別の数値化と通知機能を設計・実装し、動作確認を実施したことが残っています。一次バックフィルは250営業日分を完走し、一括算出も確認されています。追加取得対象は597銘柄、台帳は3,706銘柄という当時の記録値です。これは現在の公式上場銘柄数や、全銘柄に欠損がないことを示す数字ではありません。
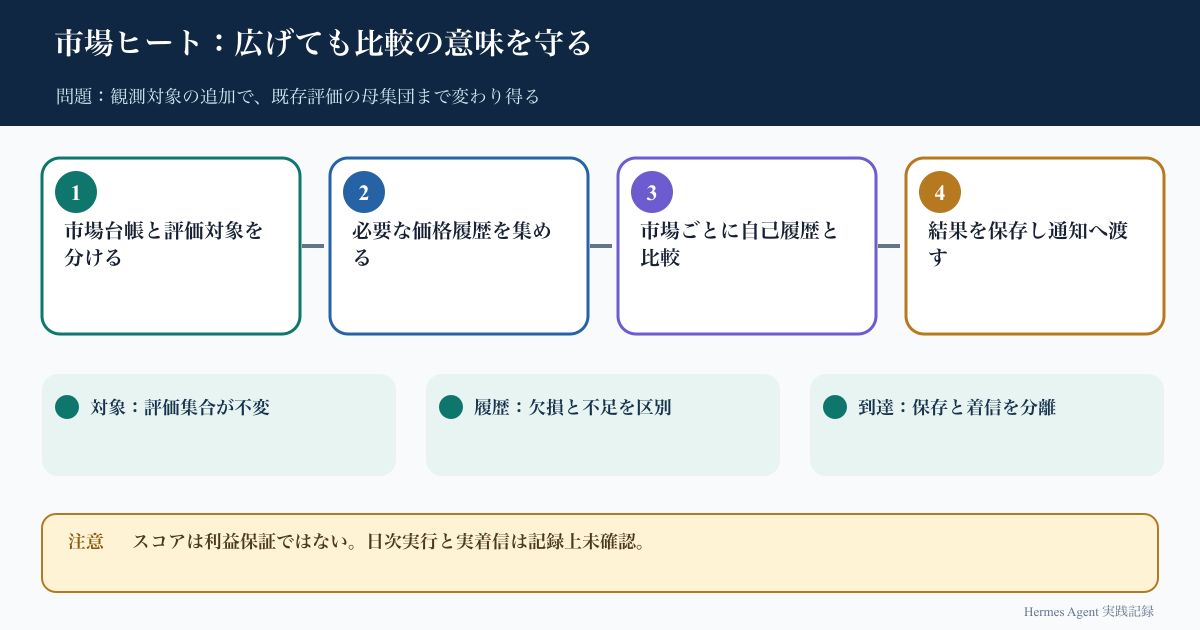
成果は開発ブランチへの取り込みまで確認できます。一方、通知の実着信、翌日の自動実行、本番ブランチへの反映は記録上の残件です。本記事でも「日次運用まで完全に成功した」とは書きません。また、以下の細かな比較方式とテーブル境界は14日の設計を説明したもので、15日の要約だけで全実装の一致を保証するものではありません。
仕組みを分解する
比較対象が少ないときは、比較軸を見直す
今回対象とする東証の市場区分は三つです。JPXの公式説明でも、それぞれ異なるコンセプトを持つ独立した市場として整理されています。多数のテーマ同士を比べる方法を、そのまま三つの市場へ当てはめると、少数の値の並び方に評価が強く左右されます。三市場の横断比較が計算不能という意味ではなく、用途に合うかを見直す必要があるということです。
設計では、各市場をその市場自身の過去と比べる時系列のrobust zへ変更しました。「他市場より大きいか」だけでなく、「普段のこの市場と比べてどれほど違うか」を見る方向です。中央値と中央値絶対偏差(MAD)を使う考え方は、極端な値の影響を抑えるための選択肢になります。ただし、外れ値に強いことと、未来を正しく予測できることは別です。
収集対象と評価対象を同じ表にしない
もう一つの要点は、新しい市場台帳と既存の個別評価対象を分けることです。設計上は`market_universe`に観測対象を保持し、価格は共通の保存先に置きながら、既存の評価対象`stocks`を変えない境界を設けました。
共通の価格表を読む処理は要注意です。設計記録では、テーマヒートの基準中央値、価格イベント検知、事後リターンの相対化母集団を点検対象にしています。価格表へ新しい行が入っただけで、これらが自動的に全市場へ広がらないよう、評価対象との対応を明示する方針でした。
全体の流れは、①市場台帳を定義する、②必要な価格履歴を集める、③市場ごとに集計し自己履歴と比較する、④算出結果を保存して通知へ渡す、という四段階です。通知は出口であって、データの正しさを代わりに証明するものではありません。
小さく再現する手順
最初から外部APIへ大量取得を依頼せず、架空の対象だけで境界を試します。以下は実プロジェクトのコードではなく、評価対象を保護する最小の例です。実銘柄や個人情報は使っていません。
“`python
evaluation_ids = {"DEMO_A", "DEMO_B"}
market_ids = {"DEMO_A", "DEMO_B", "DEMO_C"}
prices = {"DEMO_A": 10, "DEMO_B": 20, "DEMO_C": 90}
evaluation_prices = {
key: value for key, value in prices.items()
if key in evaluation_ids
}
assert set(evaluation_prices) == evaluation_ids
assert market_ids – evaluation_ids == {"DEMO_C"}
“`
確認したいのは、収集対象にDEMO_Cが増えても、既存評価へ入る対象集合は変わらないことです。件数だけでは、ある対象が抜けて別の対象が入る入れ替わりを見逃します。追加前後の識別子集合を比較するほうが、意図した境界を直接確かめられます。
次に、架空の履歴系列で中央値とMADを計算し、通常の系列、一定値しかない系列、欠損を含む系列を別々に試します。MADがゼロなら無条件に割り算しません。「算出不可」や別の処理へ分岐する方針を先に決めます。SciPy公式資料も、空配列のMADがNaNになることや欠損の扱いを説明しています。本番で同じライブラリを使ったという主張ではなく、計算の境界を理解するための参考です。
最後に、過去データを少量だけ再計算して保存結果を読み戻します。営業日ごとの欠損、対象市場、入力期間を確認し、通知文のプレビューを作ります。ここまでをローカルで終えてから、利用契約や取得上限に沿って本取得を行う順序なら、集計ミスによる不要な通信を減らせます。
確認指標
確認欄は「対象」「履歴」「到達」の三つに分けると整理できます。対象では、観測台帳の区分別件数と既存評価対象の集合差分を確認します。履歴では、取得期間と実際に計算できた日付を分け、必要な履歴が不足する市場を見えるようにします。到達では、保存済み、通知処理実行済み、受信先で確認済みを別々に記録します。
今回の250営業日という値は、バックフィル作業の範囲です。全期間でヒート指標が算出可能だったことや、統計的に十分な履歴があることまで意味しません。新規上場や休場、データ欠損があるため、必要履歴数と利用可能履歴数を市場・日付ごとに照合する確認を推奨します。これらの詳細検査がすべて完了したという観測値は、今回の要約記録にはありません。
失敗しやすい点と安全策
一つ目は、区分名だけを変えて既存の正規化を流用することです。比較対象の数と性質が変わったら、横断比較か自己履歴比較かを選び直します。両者の値を同じ尺度だと思って過去グラフへつながないことも大切です。
二つ目は、価格表の全行を評価対象として扱うことです。共通テーブルは再利用しつつ、読み取り側で対象集合を明示します。新しい観測対象の追加と、個別評価対象を広げる意思決定を分離してください。
三つ目は、履歴不足をゼロで埋めて正常な値に見せることです。ゼロは実測値である可能性があります。欠損、算出不能、通常値を区別し、通知でも判定できない理由を残します。
四つ目は、開発ブランチへの取り込みを本番運用完了と呼ぶことです。保存、定期実行、実着信を別のチェック項目にし、未確認ならそのまま残します。急いで成功と宣言するより、どこまで確かめたかが明確なほうが次の担当者に役立ちます。
再現チェックリスト
- [ ] 観測対象と既存評価対象を別々に定義した
- [ ] 追加前後の評価対象集合を比較した
- [ ] 市場の横断比較と自己履歴比較を区別した
- [ ] MADゼロ・欠損・履歴不足の扱いを決めた
- [ ] バックフィル範囲と算出可能期間を分けた
- [ ] 保存結果を読み戻して日付と区分を確認した
- [ ] 通知実行と実着信を別々に確認した
- [ ] スコアを投資成果の保証として説明していない
次に改善するなら
次の改善案は、データ拡張前後の母集団差分を自動で検査することです。価格取得対象が増えたとき、既存評価へ新しい対象が混入していないかをチェックし、意図的な変更だけを承認する形にできます。これは本記事で完了を確認した機能ではありません。
また、基準期間、最低履歴数、欠損理由を保存結果へ添えると、後からスコアの意味を追いやすくなります。当面の残件は、記録上未確認の自動実行と実着信、本番反映の扱いを確かめることです。派手な数値より、同じ意味の数値を継続して作れることを優先します。
参考情報
- 執筆根拠:2026年9月14日・15日の非公開日次記録。前者は設計、後者は実装・バックフィルと残件の記録として参照しました。
- [JPX:市場区分見直しの概要](https://www.jpx.co.jp/equities/improvements/market-structure/01.html) — 市場区分とコンセプトを2026年9月16日に確認。
- [SciPy:median_abs_deviation](https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.median_abs_deviation.html) — MADと欠損時の仕様を同日に確認。公開時にも利用する実装の現行仕様を再確認してください。