
新しいデータを保存する変更と、そのデータで順位を変える変更は、同じリリースで行う必要がありません。両方を一度に動かすと、順位が変わった理由が取得処理なのか、採点式なのかを切り分けにくくなります。毎日動く評価バッチでは、下流の対象選定まで影響が広がります。
今回は、割安度の指標を追加した実装を題材に、取り込みを先行させ、採点への反映を既定OFFにした進め方を紹介します。主題は指標の優劣ではなく、比較できる状態を作ってから変更を承認する境界です。本記事はソフトウェア・データ運用の説明であり、投資助言ではありません。順位相関や検証結果は利益を保証しません。
最近の取り組みで確認できたこと
2026年9月25日の非公開作業記録には、PERと予想PERなどの取り込み、保存列の追加、比較レポートの作成が残っています。従来の割安度はPBR単独で、拡張版はPBR・PER・予想PERを使います。実装では`VALUE_PILLAR_EXT`を既定で無効にし、新しい列を取得しても採点式は自動で切り替えません。
当日の記録では、既定OFFの状態で3,112件のスコアを従来結果と照合し、不一致0件でした。これは過去の実測記録であり、今回その全件比較を再実行したわけではありません。保存・表示の拡張と、本番で使う採点構成を分離した点が重要です。
10月8日には実装と比較レポートを確認し、関連する単体テスト16件を再実行して全件成功しました。対象はコミット済みのテストファイルで、プロジェクト全体には未コミットの文書変更等が残っています。テストは一時DBや代替クライアントを使う範囲であり、現在の外部API接続や本番採点の再検証ではありません。本番切替の完了も確認していません。
仕組みを分解する
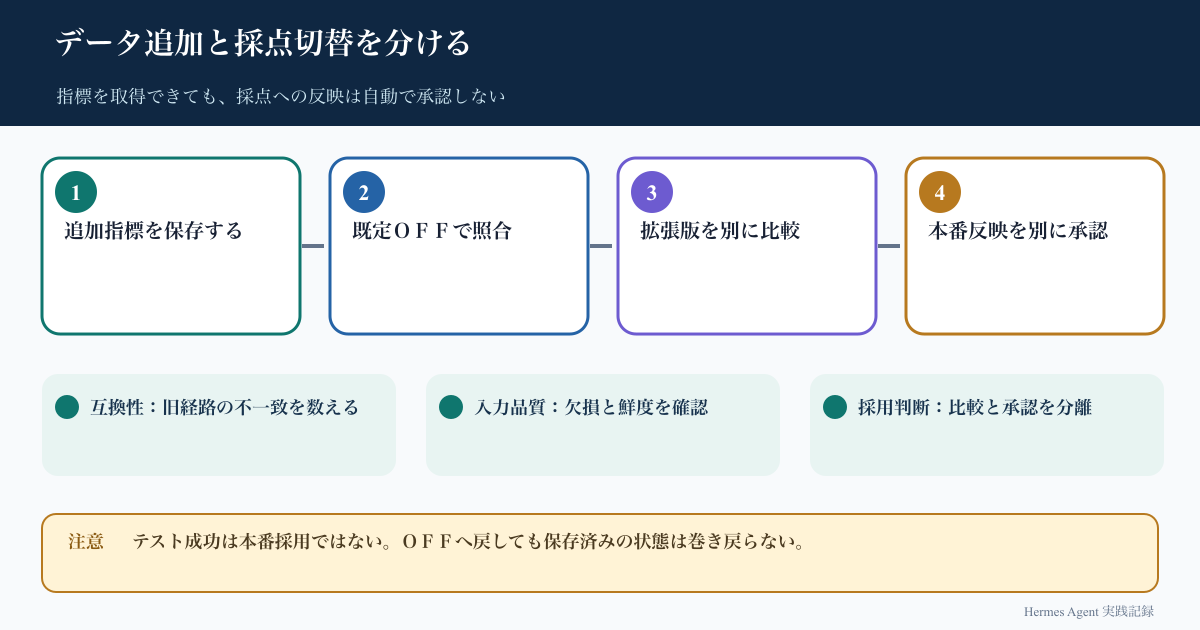
**第一に、保存と利用を分けます。** 追加データは日付と対象を揃えて保存しますが、既存処理が参照する採点列はそのままにします。「列が存在する」と「その列が意思決定に使われる」を別の状態として扱うためです。
**第二に、旧経路を残します。** 手元の実装では設定値を読み、割安度の構成列を選びます。既定OFFならPBRだけ、ONなら二つのPER系指標も含めます。設定の変更が必要なのは採点に使う側であり、取り込みが成功しただけでは切り替わりません。
**第三に、同じ入力で比較します。** 旧版と拡張版で、対象日、母集団、欠損処理を揃えます。旧経路が変わらないことを先に確認し、その後で拡張版による差を見る順序です。新旧の出力を同じ保存先へ上書きすると、比較基準を失います。
**第四に、反映判断を別に残します。** 比較資料ができたことと、本番へ採用したことは別の完了条件です。今回の記録でも、本番切替は判断待ちでした。順位が変われば評価対象や後続の集計も変わるため、単なる表示項目追加として扱わないことが必要です。
既存の評価尺度の記事はPBRを使う採点の説明、新評価軸の記事は重複や値の張り付きの診断が中心でした。今回は、取得済みの新指標をすぐ採用せず、旧結果の一致と反映承認を別々に確かめる導入手順が読者への持ち帰りです。
小さく再現する手順
まず架空の対象A〜Fを作り、同じ業種、同じPBRに揃えます。PERと予想PERだけを段階的に変えれば、旧経路では差が付かず、拡張経路では差が付くという契約を調べられます。これは人工的なテスト入力であり、未知の実データに対する精度評価ではありません。
次は説明用の疑似コードです。実プロジェクトのコマンドではなく、自分の採点関数に合わせて置き換えてください。
“`text
入力 = 架空の同一業種データを用意する()
旧結果 = 採点(入力, 構成列=[PBR])
拡張結果 = 採点(入力, 構成列=[PBR, PER, 予想PER])
検査する(旧結果では全対象が中立点)
検査する(拡張結果では低PER側が高得点)
保存する(旧結果, 別の比較用保存先)
保存する(拡張結果, 別の比較用保存先)
“`
実際の関連テストも、構成列をテスト内で差し替え、旧版の中立点と拡張版の並び方を検査します。pytestの`monkeypatch`は属性や環境変数を一時変更し、テスト終了後に元へ戻す仕組みです。ただし、環境変数を起動時に一度だけ読む実装では、読み込み後の変数変更だけで設定が更新されるとは限りません。今回のテストは読み込み済みの構成列を差し替えており、起動時の設定読込そのものとは検証範囲が違います。
続いて、古いデータ、負の値、未開示を表す欠損を混ぜます。実装の関連テストには鮮度切れや非正値を使わない確認もあります。取得できない日でも列の形が維持されるかを調べれば、採点以前の結合処理の失敗も見つけやすくなります。
確認指標
確認は三層に分けます。**互換性**では既定OFFの新旧不一致件数、**入力品質**では欠損・鮮度・対象の一致、**採用判断**では同一条件での比較結果と承認記録を見ます。テスト成功件数だけで三層を済ませないことが大切です。
9月25日の比較資料は105断面を用意し、20営業日先を評価できた101断面では、平均順位相関が現行0.0592、拡張0.0707と記録されています。当時の採用基準は20日相関が現行以上で、差分のt値が負でないことでした。記録上は基準を満たしますが、これはその比較条件内の結果です。今回、過去データの再計算はしていません。
SciPyの公式説明では、Spearman相関は二つの値の単調な関係を測ります。相関の改善は運用収益の改善と同義ではありません。また元資料は隣接断面の将来リターンが重なり、系列相関を補正していないと明記しています。日数をそのまま独立標本数として扱ったり、t値から採用の確実性を強調したりしないでください。
失敗しやすい点と安全策
第一は、取り込み成功を採用承認と同一視することです。比較用に保存する段階を設け、誰がいつ反映を認めたかを別に記録します。自動取得の成功通知だけで設定をONにする設計は避けます。
第二は、欠損を「問題なし」と読むことです。中立点で補う設計でも、既知の指標だけを使う場合と合成結果が同じとは限りません。欠損時の分母と重みを確認し、正常値だけのテストで済ませないようにします。
第三は、OFFへ戻せばすべて元に戻ると思うことです。フラグは次の計算経路を戻せても、既に保存した順位、選定済みの対象、後続処理の履歴までは巻き戻しません。切替日と出力の計算条件を残し、再計算が必要な範囲を区別します。これは今後の運用設計上の推奨で、完全な巻き戻し手順の実証ではありません。
第四は、過去の良い比較値を今後へ一般化することです。取引コストも売買可能性も今回の比較では評価されていません。別期間での確認や、重複期間を考慮した不確実性評価を、採用基準とは別の課題として残します。
再現チェックリスト
- [ ] 保存する列と採点に使う列を分けた
- [ ] 新機能の既定値を明記した
- [ ] 同じ入力で旧経路の不変を確認した
- [ ] 欠損・古い値・非正値のテストがある
- [ ] 比較出力が本番結果を上書きしない
- [ ] テスト結果と本番切替の承認を分けた
- [ ] OFFへ戻した後も残る状態を列挙した
次に改善するなら
次の候補は、計算条件を出力へ保存する運用と、切替前後の選定差分の監視です。期間を分離した比較や系列相関への対処も残ります。これらを今回の達成事項へ加えず、「データは入った」「旧経路は保った」「採用は別途判断する」という三つの状態を明確にすることから始めます。
参考情報
- 作成根拠:2026年9月25日の非公開日次記録、同日の比較レポート、10月8日に確認した実装と関連単体テスト。原記録は公開資料ではありません。
- [pytest:monkeypatch](https://docs.pytest.org/en/stable/how-to/monkeypatch.html) — テスト内の設定変更と終了後の復元。
- [SciPy:spearmanr](https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.spearmanr.html) — 順位相関の定義と解釈。
公式資料の確認日:2026年10月8日。外部データサービスの現在の契約条件・提供範囲はこの記事では判断していません。