
AIが評価文から新しい数値を抽出できるようになると、項目を増やすほど判断が精密になるように感じます。しかし、既存スコアと同じ内容を別名で数えているだけかもしれません。あるいは、ほとんどの対象に同じ値が付き、比較には役立たない項目もあります。
今回は、新しい評価軸を既存スコアと突き合わせた実施記録から、「追加された列」と「追加された情報」を区別する方法を整理します。モデル同士の優劣ではなく、評価項目そのものの役割を点検する話です。題材は銘柄評価ですが、本記事はソフトウェア・データ運用の説明であり、投資助言ではありません。相関や検証結果は利益を保証しません。
最近の取り組みで確認できたこと
2026年9月21日の作業記録では、新評価軸8項目と従来スコア11種について、3,211件・42評価日を対象に比較資料を作成しています。順位相関のヒートマップ、散布図、グレード別平均、将来リターンとの比較、見立てが食い違う対象の一覧を含み、ブラウザ表示と開発ブランチへのマージまでが記録されています。リモートへのpushは未実施でした。
記録上の重要な診断は二つです。一つは、新項目の多くが既存の事業評価やカテゴリ点と整合していたこと。もう一つは、リスクが主力事業に直結するかという項目で、グレード別平均が0.88〜0.92に集中していたことです。前者は同じ情報の再表現、後者は区別のしにくさを疑う材料になります。
一過性利益や供給制約に関する項目は、既存尺度との関連が比較的弱い候補として残りました。ただし、弱い順位相関は統計的独立の証明ではなく、新しい予測力の証明でもありません。文章の読み取り自体が正しいか、採用する項目や重みをどうするかは未検証・未決定です。この記事も集計の再実行ではなく、当日の記録から確認できる範囲を扱います。
仕組みを分解する
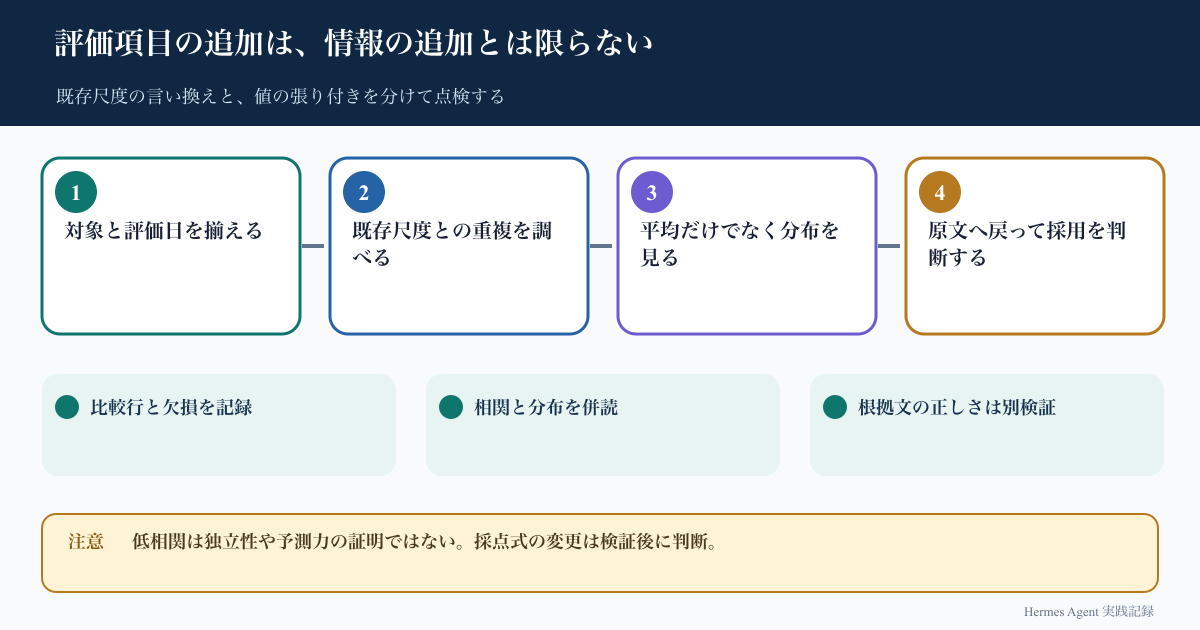
点検は四段階に分けると、相関表だけで結論を出す危険を減らせます。
**第一段階は、比較する行を揃えることです。** 対象と評価日の組をキーにして、新旧の値を結合します。別の日の文章から作った新項目を過去のスコアへ混ぜれば、項目差と時点差を区別できません。欠損や重複を先に数え、結合できた行だけで何を比較したか明記します。
**第二段階は、既存尺度との重複を見ることです。** 順位相関は、片方が増えるともう片方も増える、または減るという単調な関係を調べる道具です。逆向きに符号化した同種の項目なら、負の相関も重複の手掛かりです。総合点だけでなく対応するカテゴリとも比べ、名称ではなく測っている内容を確認します。
**第三段階は、分布と張り付きを見ることです。** グレード別平均に加え、値の種類、中央値、ばらつき、欠損率を確認します。グループ平均が近くても各行まで一定とは限らないため、平均だけで項目を削除しません。逆に、値がほぼ一定なら相関の小ささを「既存尺度にない情報」と読んではいけません。
**第四段階は、原文へ戻ることです。** 既存評価と食い違った例を抜き出し、根拠文と判定の対応を人が確認します。矛盾が新しい視点によるものか、否定表現の誤読や欠損補完によるものかを区別したうえで、継続調査、定義変更、採用保留に分けます。
小さく再現する手順
最初は本番の採点式を変更せず、読み取り専用の比較用ファイルを用意します。たとえば架空の対象A〜Dについて、同じ評価日の既存点、新項目、根拠文、欠損理由を並べます。新項目を「需要が強いほど高い値」にしたのか、「需要減退が強いほど高い値」にしたのかも記載してください。符号の意味が違えば、同じ情報でも相関の向きは逆になります。
次は、単なる列追加と情報追加を区別するための疑似コードです。関数名は説明用であり、そのまま実行するライブラリAPIではありません。
“`text
rows = 同じ対象と評価日で新旧を結合する()
欠損数と重複数を記録する(rows)
for 新項目 in 比較対象:
分布を保存する(rows, 新項目)
既存各尺度との順位相関を保存する(rows, 新項目)
食い違い例と根拠文を確認用に抽出する(rows, 新項目)
採用判断は別のレビュー記録へ残す()
“`
具体的には、「既存点と同じ順に並ぶ列」「全行で同じ値になる列」「順序は異なるが根拠文の確認が必要な列」を架空データで用意すると、点検の意味を説明しやすくなります。一定値の列は、順位相関を0に置き換えず「定義できない」と表示する設計にします。
SciPyの公式資料では、`spearmanr`は一定値の入力に警告を出し、相関係数として`nan`を返します。これは無相関という測定結果とは別です。またscikit-learnの`VarianceThreshold`は低分散の特徴量を除くための機能で、既定では分散が0の列を除きます。ただし、今回の実施記録がこれらの機能を使用したと確認できたわけではありません。再現時に選べる道具として紹介しています。
確認指標
確認する軸は、**比較可能性・追加情報・判定の正しさ**の三つです。比較可能性では、結合前後の件数、評価日の範囲、欠損数を保存します。実記録の3,211件は比較資料の対象件数であり、すべての相関ペアに有効な行が同数あったことや、独立した標本が同数あったことまでは意味しません。
追加情報では、既存尺度との相関と新項目の分布をセットで読みます。相関が弱くても値の大半が同じなら、役に立つ差分とは限りません。判定の正しさでは、抽出した根拠文に対し、人の読みと一致したか、判断不能だったかを分けます。今回、その正解率は測定済みではありません。
「相関がこの値以下なら採用」という共通の基準は置きません。尺度の目的、符号、対象期間を先に固定し、検証用の期間で再確認する必要があります。重複が強い項目でも、説明のしやすさや監査上の意味があれば補助表示として残す選択肢があります。
失敗しやすい点と安全策
第一に、低相関を価値と取り違えることです。誤読やノイズでも既存尺度との相関は弱くなります。原文の確認を省かず、予測に使う場合は期間を分けて追加効果を検証します。
第二に、グレード平均だけで「全件が一定」と判断することです。今回確認したのは平均の集中であり、全行の値が同一だったという主張ではありません。分布と対象別の例を併記して、失われた差と残っている差を確かめます。
第三に、新旧の似た項目を両方足してしまうことです。同じ事業の強さを二重に加点すると、列数は増えても判断が偏ります。採点式へ入れる前に、補助説明用なのか、既存項目を置き換えるのかを決めます。
第四に、同一対象の反復評価をすべて独立した観測として扱うことです。日付別や対象群別でも傾向を確認し、集計件数だけで確実性を強調しません。比較資料の完成と、採点改善の実証も別々に記録します。
再現チェックリスト
- [ ] 新旧の評価日と対象が一致している
- [ ] 結合後の件数、重複、欠損を記録した
- [ ] 各尺度で大きな値が何を意味するか説明した
- [ ] 相関と分布を両方見ている
- [ ] 一定値や計算不能を0扱いしていない
- [ ] 食い違う例の原文を確認する欄を設けた
- [ ] 未検証の採用・重み変更を完了扱いしていない
次に改善するなら
次の候補は、食い違い例だけでなく通常例も含むレビュー用標本を作り、人が確認した判定と照合することです。その後、項目を加えない基準と加えた構成を、別期間で比べる余地があります。どちらも今回の記録では完了していません。まず「何が分かったか」と「まだ何を証明していないか」を同じ資料へ残すことが、安全な評価軸追加の出発点です。
参考情報
- 作成根拠:2026年9月21日のローカル作業記録と同日の日次統合記録。比較資料作成と診断結果を参照しました。原記録は公開資料ではありません。
- [SciPy:spearmanr](https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.spearmanr.html) — 順位相関の意味と一定値入力時の挙動。
- [scikit-learn:特徴量選択](https://scikit-learn.org/stable/modules/feature_selection.html) — 低分散の特徴量を点検・除外する考え方。
公式資料の確認日:2026年9月22日。実施記録と一般的な再現手順は分けて記載しています。